Qué es la IA generativa
Antes de empezar
Este curso está orientado a aprender qué se puede hacer con IA generativa dentro del trabajo investigador, desde un punto de vista práctico. No hace falta saber programar ni entender cómo se entrena una red neuronal.
Lo que sí me gusta recordar en estos cursos es que el ecosistema cambia cada pocos meses: nombres, interfaces, precios, modelos, límites de uso... Por lo que el objetivo es centrarnos en las bases principales y en aspectos atemporales (como la forma de organizar un procedimiento o los criterios para decidir si un resultado sirve o no), y dar las pautas necesarias para poder adaptarse a lo que va cambiando.
El programa
El curso presencial se divide en dos sesiones de tres horas:
| Sesión | Tema | Capítulos |
|---|---|---|
| 1 | Fundamentos, herramientas y organización del conocimiento | 1–3 |
| 2 | Procedimientos reutilizables y aplicación al trabajo investigador | 4–7 |
IA tradicional vs IA generativa

Aunque hoy usemos "Inteligencia Artificial" para referirnos a los últimos avances, la IA lleva muchos años entre nosotros. Durante décadas, casi todo lo que llamábamos IA eran modelos que recibían una entrada y devolvían una predicción. Ejemplos de ello son:
- Reconocer una cara en una fotografía.
- Detectar vehículos en una cámara de tráfico.
- Segmentar una imagen médica.
- Detectar defectos en una pieza industrial.
- Clasificar un documento en una categoría.
- Decidir si un correo es spam.
En todos estos casos el espacio de salida es pequeño y está definido de antemano: una etiqueta, un número, una región...
Como puedes ver en la figura anterior, dentro del panorama de la inteligencia artificial, la IA generativa engloba métodos y técnicas capaces de generar nuevas muestras de datos. Cambia el tipo de salida: en lugar de elegir entre diferentes opciones, construye contenido nuevo (texto, imágenes, voz, música, vídeo, documentos, código...)
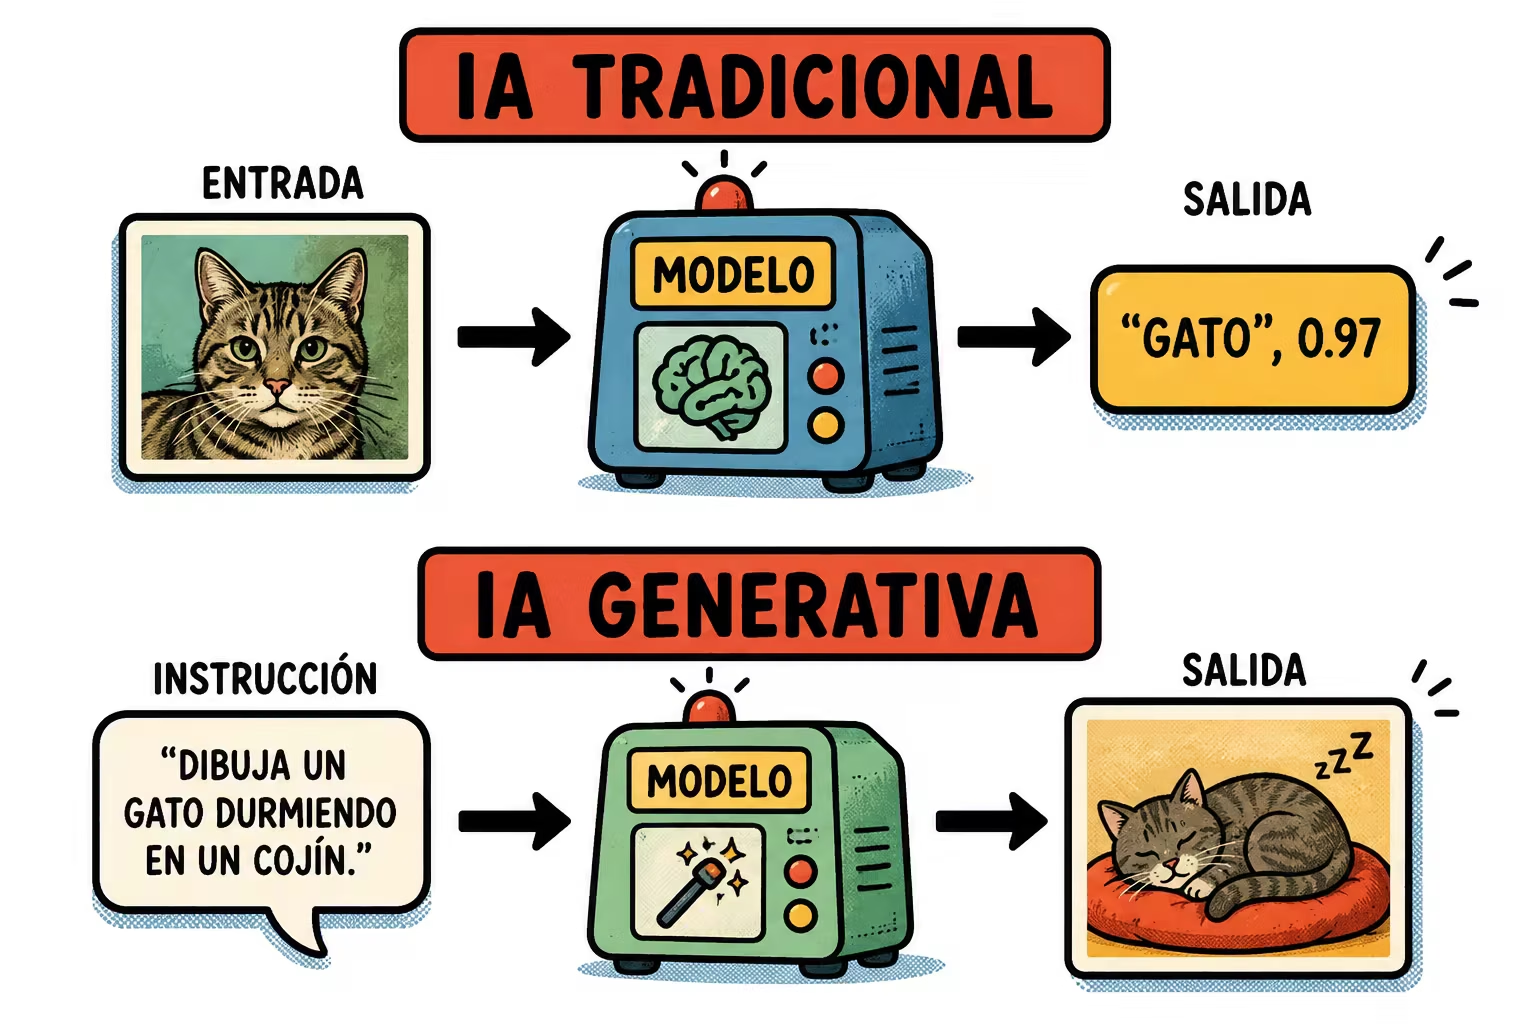
La entrada deja de ser un dato a clasificar y pasa a ser una instrucción. Y la salida deja de ser una etiqueta y pasa a ser contenido nuevo.
Evolución
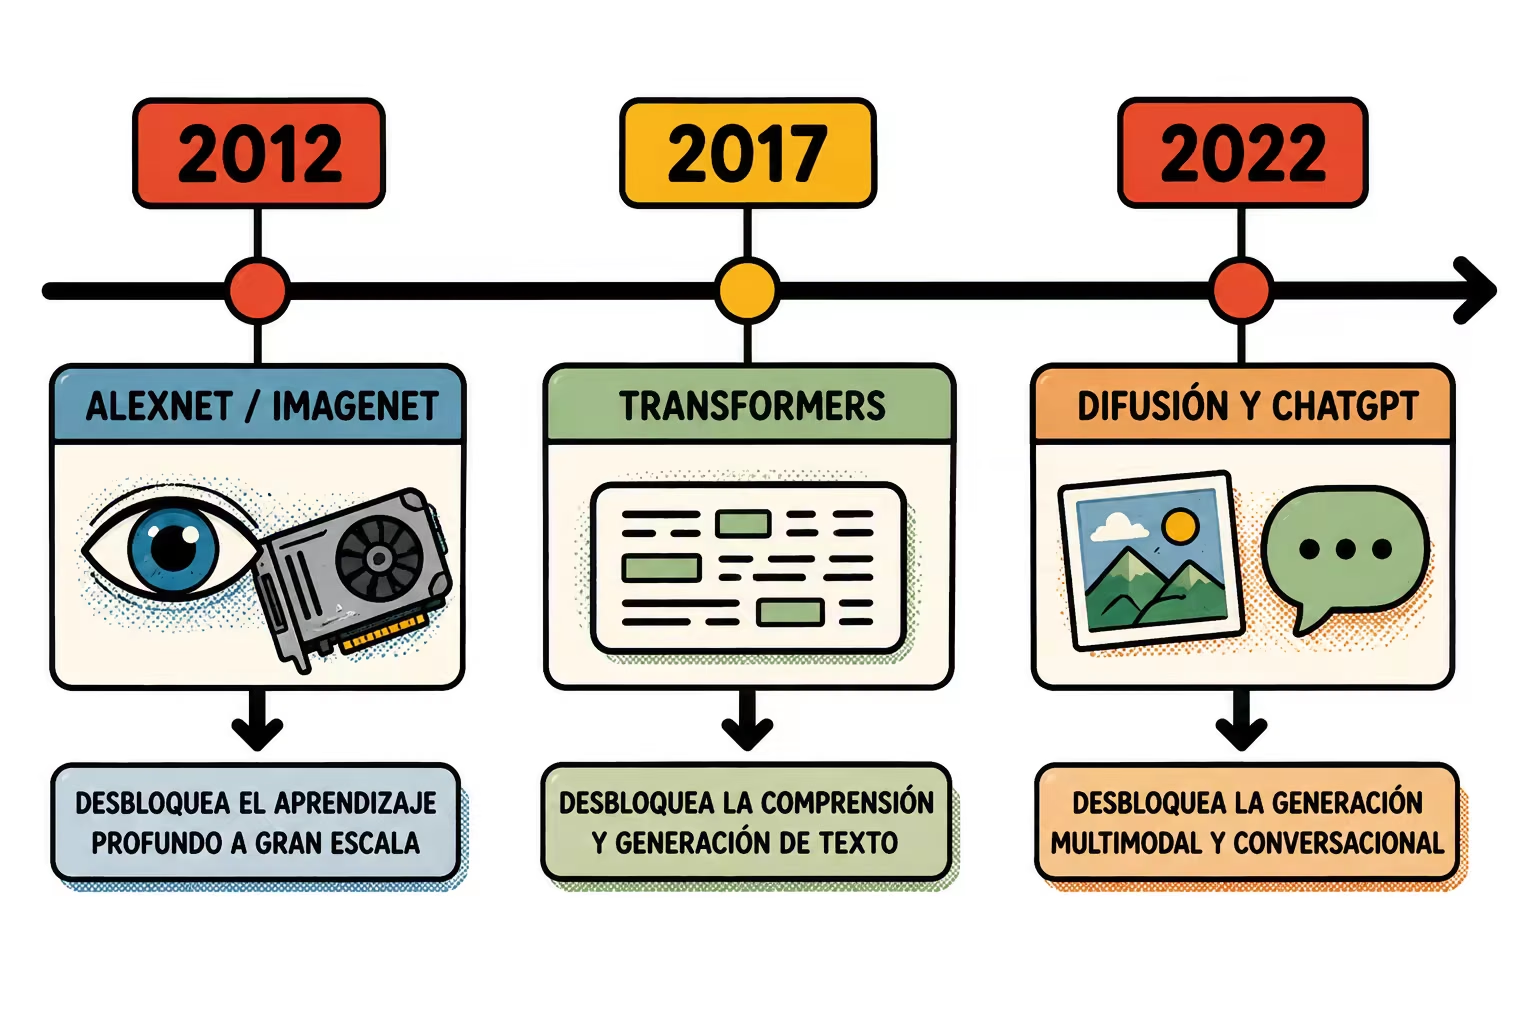
Si la IA lleva décadas entre nosotros, la pregunta razonable es por qué de repente parece que todo ha cambiado en unos pocos años. Hay muchas fechas que se podrían citar, pero estas tres explican casi todo.
2012 — las máquinas empiezan a ver. El modelo AlexNet gana la competición de clasificación de imágenes ImageNet con un margen enorme sobre los métodos tradicionales. Fue la demostración de que las redes neuronales profundas funcionaban, y arrancó la revolución del deep learning. No fue solo mérito del algoritmo: las tarjetas gráficas (GPUs), diseñadas originalmente para videojuegos, resultaron ser ideales para entrenar estas redes porque hacen muchísimos cálculos en paralelo.
2017 — el preentrenamiento escala sin etiquetas manuales. Google presenta la arquitectura Transformer. Entrenada de forma auto-supervisada, permite aprender a partir de texto sin anotar: se ocultan palabras y se pide al modelo que las reconstruya. Es la base de ChatGPT, Gemini o Claude, pero también de aplicaciones como la predicción del plegado de proteínas (AlphaFold).
2022 — llegada al público. Aparecen los modelos de difusión que popularizan la generación de imágenes (Stable Diffusion, DALL·E, Midjourney) y en noviembre se lanza ChatGPT. Por primera vez, cualquiera puede usar todo esto desde un navegador y sin saber nada de lo anterior.
Hay otro detalle de esa última década que explica también en parte el ritmo vertiginoso de los últimos años: el escalado. Al aumentar el tamaño de los modelos empezaron a aparecer capacidades para las que nunca se les había entrenado explícitamente. Un modelo entrenado únicamente para predecir la siguiente palabra acabó aprendiendo también a traducir, razonar y escribir código.
De modelos especializados a modelos multimodales
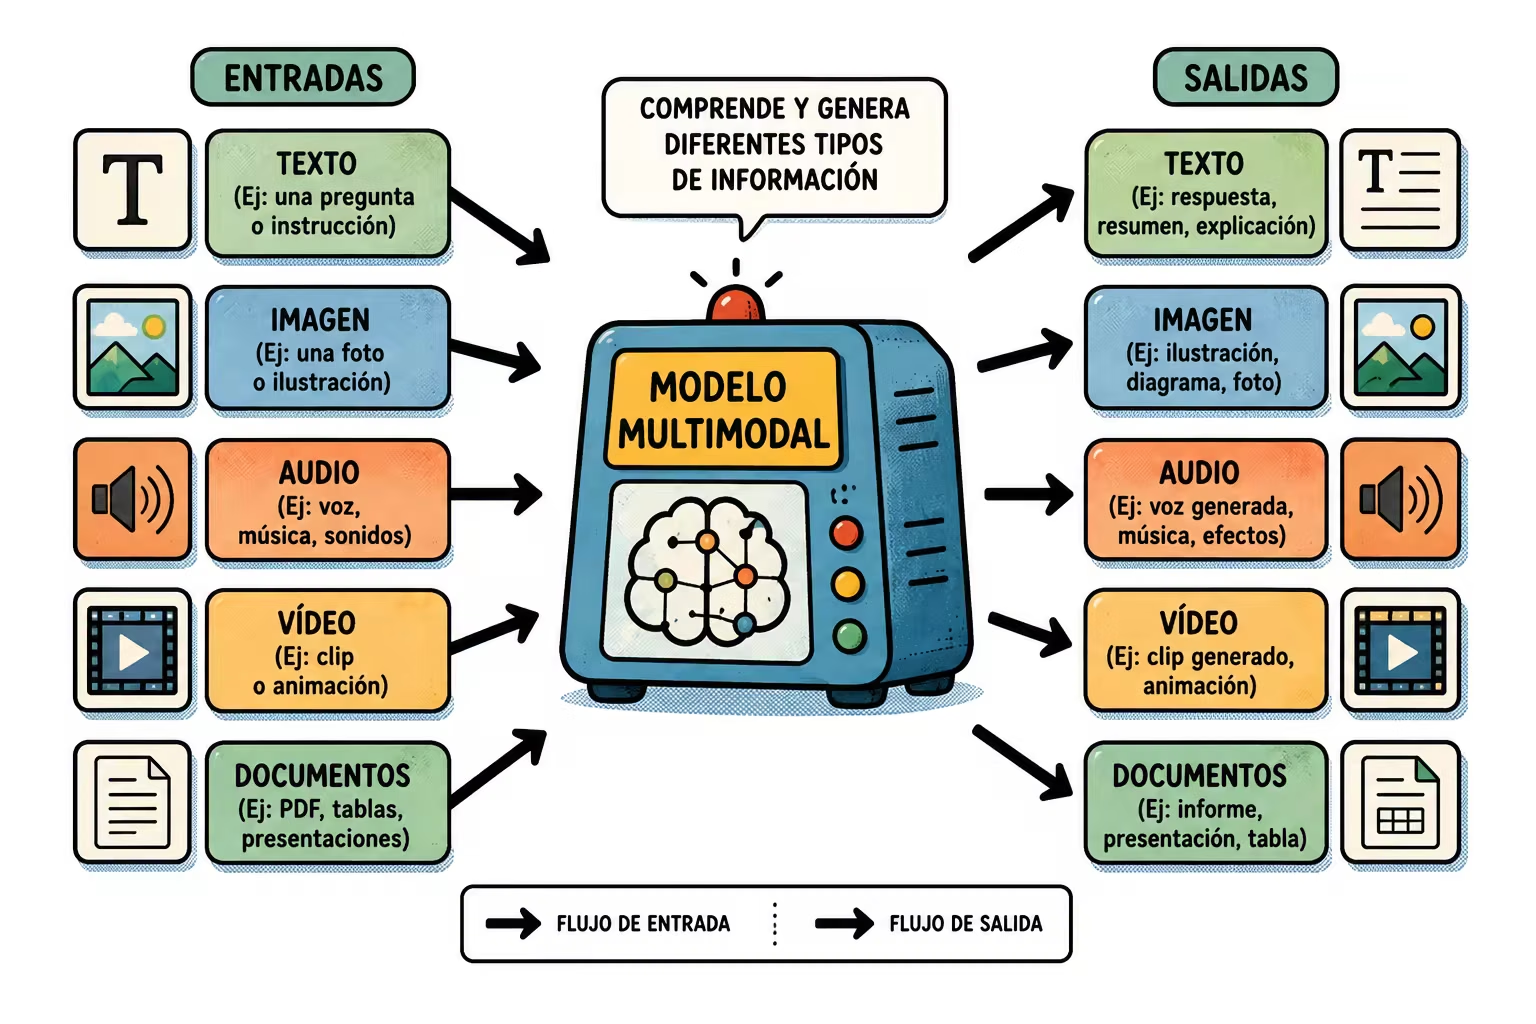
Hasta hace relativamente poco, cada tarea tenía su modelo:
- un modelo para texto,
- un modelo para imagen,
- un modelo para clasificación,
- un modelo para audio
- ...
Si querías, por ejemplo, clasificar una review en positiva/negativa y luego evaluarla de 1 a 5 estrellas, necesitabas encadenar dos modelos distintos.
¿Por qué estaba todo tan fragmentado? Porque cada uno de esos modelos se entrenaba con aprendizaje supervisado. Hacían falta miles de ejemplos etiquetados a mano para la tarea concreta que se quería resolver, y esas etiquetas no se reutilizaban entre tareas.
El preentrenamiento auto-supervisado cambió esto. Como el cuello de botella está en las etiquetas, se entrena al modelo únicamente con los propios datos, ocultando partes de ellos (como palabras de una frase o regiones de una imagen) y pidiéndole que las reconstruya. Las etiquetas salen del propio dato, así que se puede aprender a partir de cantidades enormes de material sin anotar.
Preentrenamiento y postentrenamiento
Todo lo anterior ocurre durante el preentrenamiento. En el caso de los GPT, una forma intuitiva (y simplificada) de verlo es entender el modelo como un archivo, que ocupa unos cuantos gigas, que es una compresión de Internet.
El resultado es un modelo base con muchas capacidades, pero que no tiene por qué responder como esperamos en una conversación ni tampoco tiene acceso a herramientas. Esto se le enseña al modelo en la fase de postentrenamiento: se utilizan ejemplos de instrucciones y técnicas de aprendizaje por refuerzo con feedback humano (RLHF) para orientar su comportamiento hacia respuestas más útiles, seguras y alineadas con la intención del usuario.
Es ese postentrenamiento el que le da la parte de asistente conversacional. Cuando además lo colocamos detrás de una interfaz que mantiene el historial y permite intercambiar mensajes, tenemos un chatbot.
Sesgos y variabilidad
Estas dos fases de entrenamiento explican en parte de dónde salen los sesgos. Pueden proceder de los datos utilizados durante el preentrenamiento, de las preferencias introducidas durante el postentrenamiento, de las fuentes que elegimos o de la propia pregunta.
Además, dos ejecuciones del mismo prompt pueden producir respuestas distintas. La reproducibilidad cuando trabajamos con modelos de lenguaje consiste en conservar las entradas, las instrucciones, las fuentes, la versión o fecha de la herramienta y los criterios utilizados para evaluar el resultado.
Cómo procesa el modelo lo que le das
No vamos a entrar en cómo funcionan estos modelos internamente, pero hay una excepción que conviene entender: la ventana de contexto. Puede explicar por qué un modelo se salta detalles o se olvida de instrucciones previas.
El prompt
El prompt es el conjunto de instrucciones y datos que recibe el modelo. Incluye lo que escribimos, los archivos adjuntos, las instrucciones del proyecto y parte de la conversación.
Los tokens
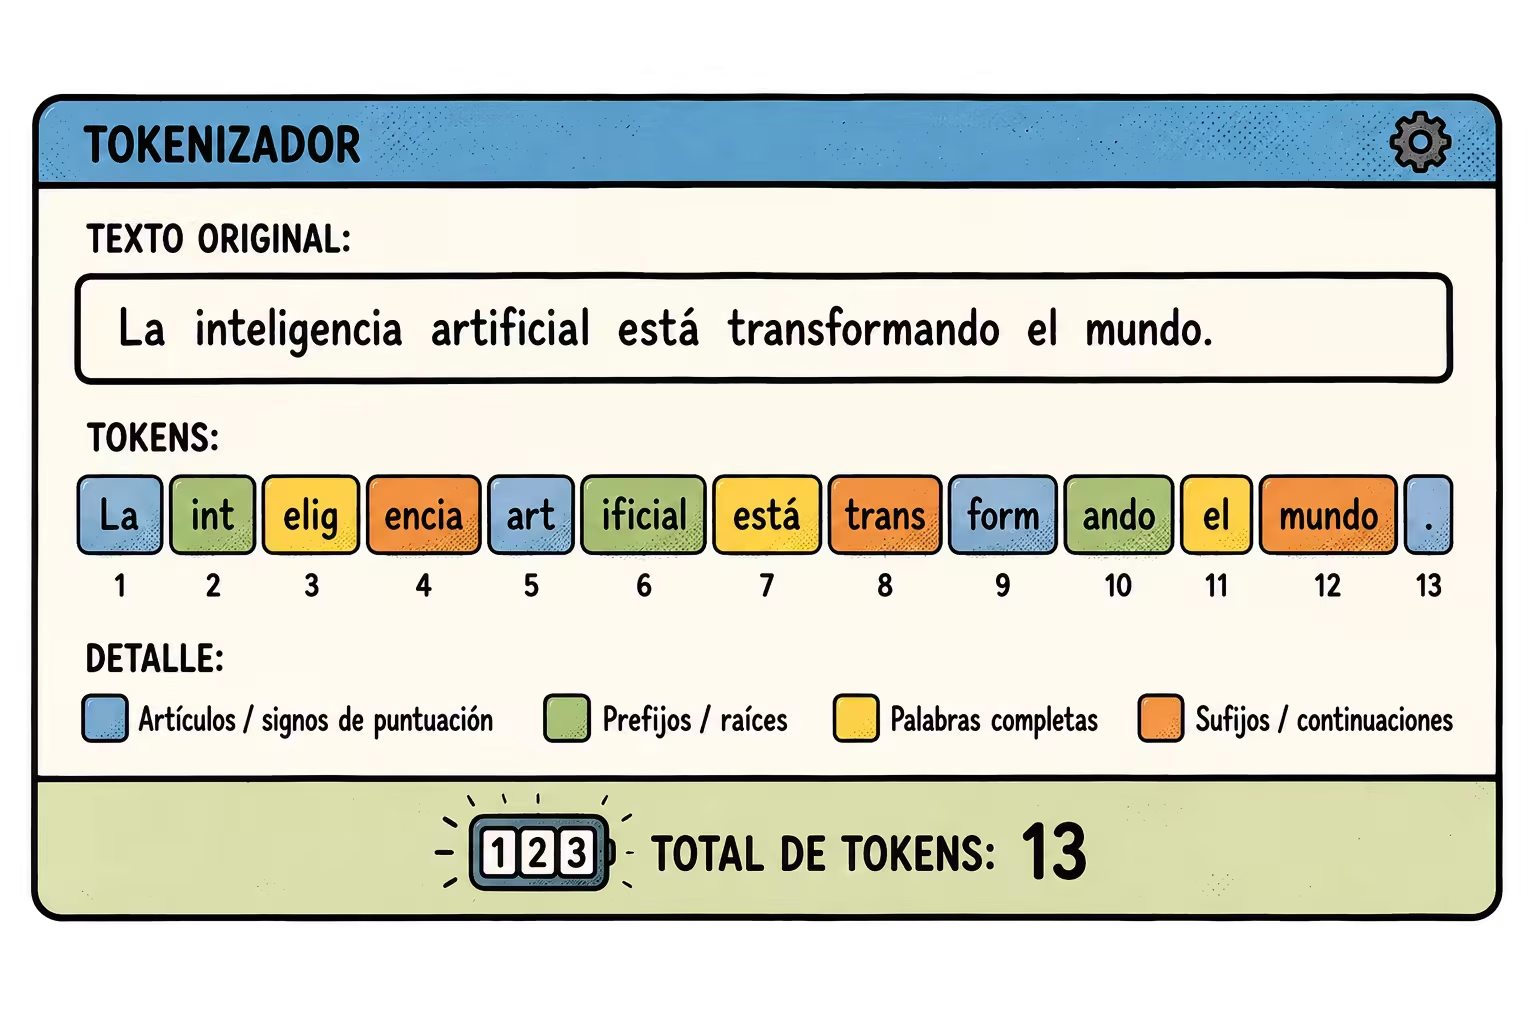
Antes de procesar nada, el texto se trocea en unidades llamadas tokens. Un token no siempre es una palabra: puede ser una palabra corta entera, un fragmento de una larga, un signo de puntuación o un espacio. Cada token se convierte después en una representación numérica, y eso es lo que realmente entra en la red.
Puedes verlo tú mismo en Tiktokenizer: pega una frase y observa cómo la parten los distintos modelos. Los acentos, las palabras poco frecuentes y los nombres propios suelen romperse en varios trozos.
La ventana de contexto
Esa secuencia no puede crecer indefinidamente. Cada modelo tiene una memoria limitada, la ventana de contexto, que admite un número máximo de tokens.
Cuando una conversación supera ese límite, la aplicación tiene que recortar, resumir o comprimir parte del historial porque el modelo olvida todo lo que queda fuera de esa ventana, aunque la interfaz siga mostrando la conversación completa. Los documentos, las instrucciones, las respuestas y los resultados de herramientas ocupan contexto.
Por eso, conviene separar tareas, mantener instrucciones breves, volver a aportar la evidencia que sea imprescindible o directamente empezar un nuevo chat. Por ejemplo, al trabajar con muchos artículos puede no ser una muy buena idea acumular todos en el mismo chat, porque según avance la conversación el texto de los primeros PDFs va a quedar fuera de la ventana.
Si quieres profundizar
Alucinaciones
Una alucinación es una salida inventada o no respaldada: una referencia inexistente, una cifra equivocada o una metodología descrita con detalles que la fuente no contiene. El problema es que suele estar redactada con la misma seguridad y fluidez que una respuesta correcta.
Puede deberse a limitaciones del propio modelo, pero también a cómo lo utilizamos:
- le pedimos información que no aparece en las fuentes disponibles;
- exigimos una respuesta incluso cuando falta evidencia;
- la pregunta es ambigua y el modelo completa los huecos con una continuación plausible;
- mezclamos demasiados documentos o instrucciones distintas en el mismo chat;
- la evidencia relevante ha quedado fuera de la ventana de contexto.
Este último caso es fácil de confundir con un problema de conocimiento. El dato sí se aportó, pero el modelo ya no puede verlo y reconstruye la respuesta a partir de lo que conserva.
Otra forma de reducir el riesgo es dotar al modelo de herramientas: búsqueda, recuperación de documentos, acceso a conectores, etc. Así puede consultar la información necesaria en lugar de depender únicamente de lo aprendido durante el entrenamiento o de lo que todavía cabe en el contexto. Veremos más en el próximo capítulo.