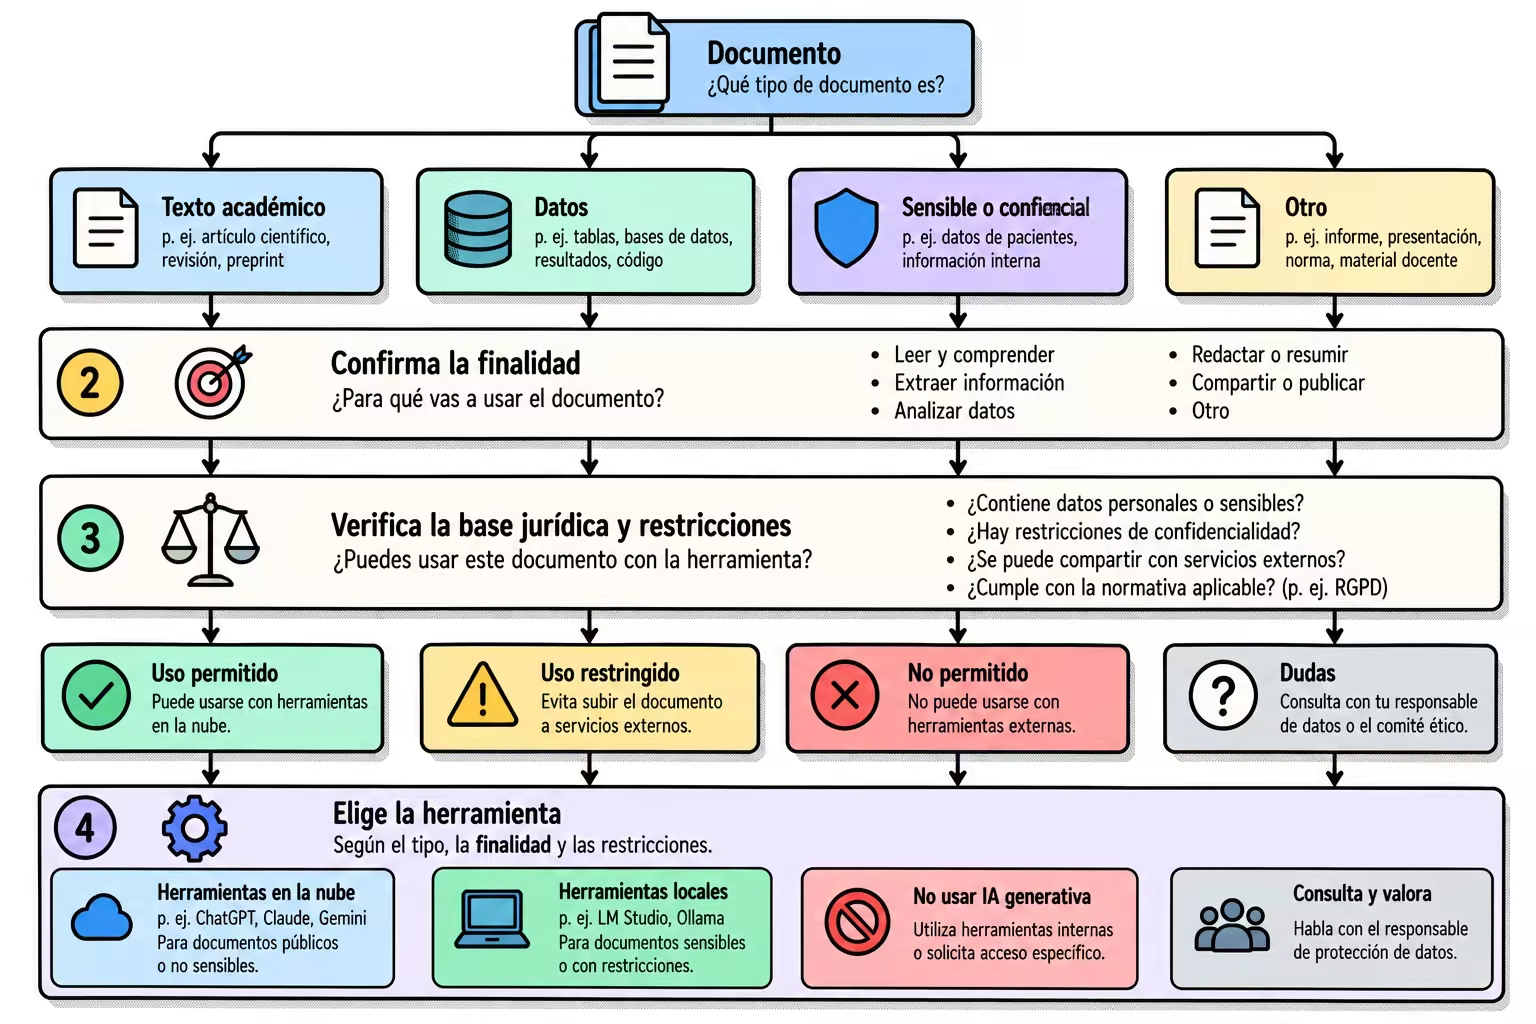
Ética, RGPD y gobernanza
Nunca está de más decir que NO se puede introducir datos de pacientes, participantes, muestras o personal en una herramienta de IA sin base jurídica, autorización institucional, contrato, etc.
Clasificar antes de utilizar
Los datos de salud tienen protección reforzada en el Reglamento General de Protección de Datos. Seudonimizar no equivale necesariamente a anonimizar: si existe una vía razonable de reidentificación, siguen siendo datos personales.
El Comité Europeo de Protección de Datos señala que la anonimidad de modelos y tratamientos con datos personales debe evaluarse caso por caso. Ante dudas, consulta al delegado de protección de datos y a los comités institucionales.
| Nivel | Ejemplos | Tratamiento inicial |
|---|---|---|
| Público | Artículos abiertos, guías publicadas | Uso permitido con verificación |
| Interno | Protocolos, borradores, resultados no publicados | Solo servicios autorizados |
| Confidencial | Manuscritos en revisión, propiedad intelectual | Evaluación específica y acceso restringido |
| Personal o sanitario | Historia clínica, genómica, imágenes identificables | No usar sin marco institucional explícito |
Trabajar con documentos confidenciales
Que un documento sea confidencial no significa automáticamente que sea ilegal utilizar IA para trabajar con él. La pregunta es si estás autorizado a comunicar esa información al proveedor y si el servicio, el contrato y la configuración utilizados cumplen las condiciones aplicables.
Por ejemplo, habría que revisar:
- el acuerdo de confidencialidad, contrato o política interna;
- si el proveedor está aprobado por la institución y sujeto a obligaciones adecuadas;
- qué cuenta, espacio de trabajo y modalidad de ejecución se están utilizando;
- si existen datos personales, sanitarios, secretos empresariales o propiedad intelectual;
- dónde se procesan los datos, cuánto tiempo se conservan y quién puede acceder;
- qué herramientas, conectores o servidores MCP pueden recibir parte del contenido.
Procesar un documento o crearlo
Desde el punto de vista de la confidencialidad, leer un documento existente y elaborar uno nuevo pueden ser prácticamente lo mismo. Si para redactarlo proporcionas resultados no publicados, código propietario, cifras internas o decisiones protegidas por un acuerdo, ya has comunicado información confidencial aunque todavía no exista el archivo final.
Hay una diferencia de alcance:
| Situación | Información expuesta al servicio |
|---|---|
| Subir el documento completo | Todo el contenido que pueda procesar el sistema |
| Redactar a partir de hechos confidenciales | Los hechos incluidos en el prompt, los archivos y el resultado generado |
| Crear una plantilla con información pública o ficticia | No se comunican los datos confidenciales que se añadirán después |
La tercera opción puede servir para pedir estructura, estilo o una plantilla y completar después el contenido sensible en un entorno autorizado.
El plan y la modalidad
En Codex, los controles de datos de ChatGPT se aplican al contenido procesado. Hay flujos locales que se ejecutan en el dispositivo, pero local no significa necesariamente que el contenido permanezca fuera del servicio, el procesamiento por lo general se hace en el cloud de OpenAI.
Según la documentación oficial de Codex, en Business, Enterprise, Edu y la API los inputs y outputs no se utilizan para mejorar los modelos por defecto. En Plus y Pro pueden utilizarse salvo que se desactive esa opción en los controles de datos. La documentación empresarial de OpenAI describe además cifrado, controles de acceso y opciones de retención; en la API, la retención depende también del endpoint y de si la organización tiene controles como Zero Data Retention.
Claude y Claude Code distinguen igualmente entre cuentas de consumo y productos comerciales. En las cuentas Free, Pro y Max hay que revisar la configuración de mejora del modelo y las condiciones de retención. Los acuerdos de retención cero solo cubren productos y organizaciones elegibles, y pueden existir excepciones según el modelo o la función.
Como regla práctica, para un documento realmente confidencial no utilizaría una cuenta personal por iniciativa propia. Confirmaría por escrito el servicio aprobado, la cuenta institucional, la configuración, la retención y los usos permitidos. Después minimizaría el contenido y evitaría habilitar conectores, navegación o permisos que la tarea no necesite.
Evaluar caso y proveedor
Antes de empezar a usar un documento, pregunta:
- Finalidad: define para qué se usarán datos y salida.
- Minimización: aporta solo lo imprescindible.
- Transparencia: registra herramienta, propósito y responsables.
- Seguridad: controla acceso, conservación, ubicación y transferencias.
- Supervisión: asigna a una persona la validación y la decisión.
- Equidad: evalúa poblaciones infrarrepresentadas y errores diferenciales.
- Trazabilidad: conserva fuentes, instrucciones, versiones y correcciones.
- Reversibilidad: permite detener el flujo y recuperar el estado anterior.
Antes de aprobar una herramienta, pregunta:
- ¿Se usan las entradas para entrenar o mejorar modelos?
- ¿Dónde se procesan y almacenan los datos?
- ¿Qué retención, borrado y exportación existen?
- ¿Qué subencargados intervienen?
- ¿Qué controles de acceso y auditoría ofrece?
- ¿Puede limitarse a fuentes autorizadas?
- ¿Cómo notifica cambios e incidentes?
- ¿Qué ocurre al terminar el contrato?
Uso en publicación científica
Las recomendaciones del ICMJE exigen responsabilidad humana, transparencia y protección de la confidencialidad; una IA no reúne los requisitos de autoría (al menos de momento). Comprueba también la política de la revista, por ejemplo las políticas editoriales de Nature Portfolio, justo antes del envío.
Registra como mínimo herramienta, versión o fecha, finalidad, material aportado, secciones afectadas, comprobación humana y declaración final.